DTP में कोताही बरतने की प्रणालीगत त्रुटि
डेस्कटॉप पब्लिशिंग (DTP) और फ़ाइल तैयारी स्थानीयकरण के मुख्य चरणों में से एक का प्रतिनिधित्व करते हैं। वे किसी भी दस्तावेज़ की दृश्य और तकनीकी नींव बनाते हैं: कुशल लेआउट कार्य के बिना, एक त्रुटिहीन अनुवाद भी अपना मूल्य खो देता है।
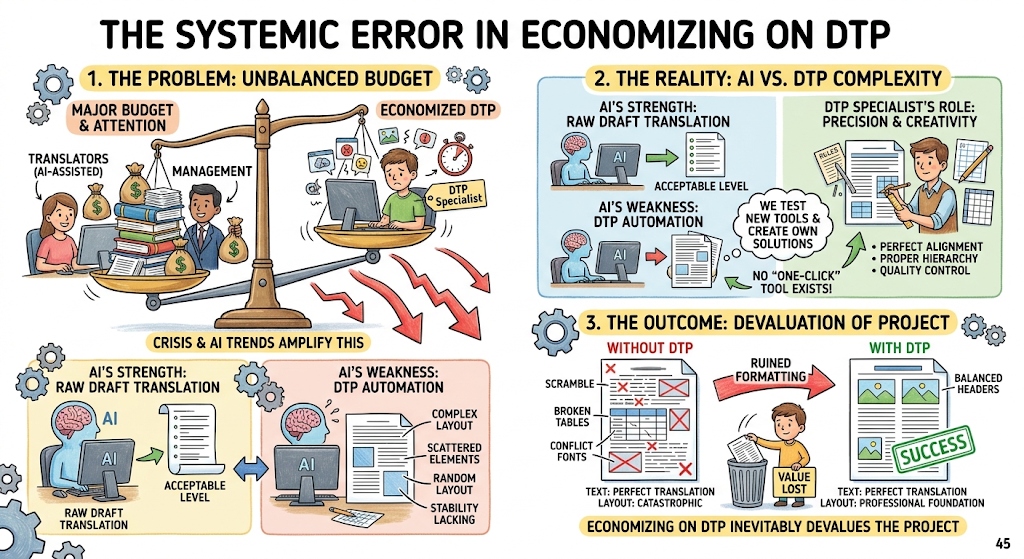
दुर्भाग्य से, कई अनुवाद एजेंसियां — जिनमें बड़े अंतर्राष्ट्रीय LSP भी शामिल हैं — अभी भी DTP को एक द्वितीयक नियमित कार्य मानती हैं। बजट और प्रबंधन का अधिकांश ध्यान अनुवादकों पर केंद्रित होता है, जबकि DTP को कम दरों और बेहद कम समय-सीमा के साथ दबा दिया जाता है। बजट बाधाओं और AI क्रांति के युग में, यह प्रवृत्ति और भी तीव्र हो गई है।
फिर भी यहीं पर एक प्रणालीगत त्रुटि निहित है। यद्यपि कृत्रिम बुद्धिमत्ता (AI) अब स्वीकार्य प्रारूप अनुवाद तैयार कर सकती है (विशेष रूप से तकनीकी सामग्री के लिए), न्यूरल नेटवर्क अभी भी DTP में विफल रहते हैं। मॉडल कभी-कभार बुनियादी मार्कअप या टेबल स्थिति का अनुमान लगा सकते हैं, लेकिन सुसंगत, उत्पादन-स्तरीय परिणाम अभी भी पहुँच से बाहर हैं। हम नियमित रूप से उभरते उपकरणों का परीक्षण करते हैं और अपने स्वयं के मालिकाना समाधान विकसित करते हैं, फिर भी बाज़ार में कोई पूरी तरह से स्वचालित "वन-क्लिक" प्रोग्राम मौजूद नहीं है जो प्रत्येक DTP चुनौती को संभाल सके। मैनुअल इंजीनियरिंग और सख्त लेआउट गुणवत्ता नियंत्रण अपरिहार्य बने हुए हैं।
लापरवाह फ़ॉर्मेटिंग सबसे पहली चीज़ है जिस पर पाठक का ध्यान जाता है। पाठ का अनुवाद भले ही त्रुटिहीन हो, लेकिन असंतुलित तालिकाएं, एक-दूसरे पर चढ़ते टेक्स्ट फ़्रेम और बिगड़ा हुआ फ़ॉन्ट पदानुक्रम दस्तावेज़ को अनुपयोगी बना देते हैं। DTP में कोताही बरतना पूरे स्थानीयकरण प्रोजेक्ट के मूल्य को अनिवार्य रूप से कम कर देता है।