Systemowy błąd oszczędzania na DTP
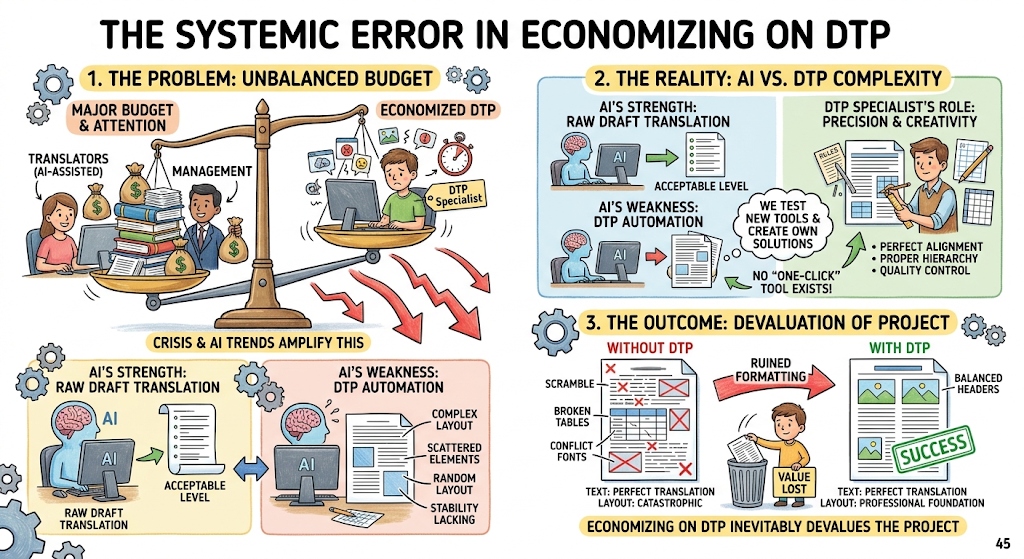
Skład komputerowy (DTP) i przygotowanie plików stanowią jeden z kluczowych etapów lokalizacji. Tworzą one wizualny i techniczny fundament każdego dokumentu: bez profesjonalnego składu nawet bezbłędne tłumaczenie traci swoją wartość.
Niestety wiele agencji tłumaczeń — w tym duże międzynarodowe firmy LSP — wciąż traktuje DTP jako drugorzędne, rutynowe zadanie. Większość budżetu i uwagi kierownictwa trafia do tłumaczy, podczas gdy skład DTP jest spychany na dalszy plan przez niższe stawki i krótsze terminy. W dobie ograniczeń budżetowych i boomu na sztuczną inteligencję (AI) tendencja ta uległa jeszcze nasileniu.
Jednak właśnie w tym tkwi błąd systemowy. Chociaż sztuczna inteligencja potrafi już generować akceptowalne wersje robocze tłumaczeń (zwłaszcza tekstów technicznych), sieci neuronowe wciąż zawodzą w DTP. Modele mogą sporadycznie odgadnąć podstawowe znaczniki lub położenie tabel, jednak powtarzalne rezultaty o jakości produkcyjnej pozostają poza ich zasięgiem. Regularnie testujemy pojawiające się narzędzia i tworzymy własne autorskie rozwiązania, jednak na rynku nie istnieje żaden w pełni zautomatyzowany program typu „jedno kliknięcie”, który poradziłby sobie z każdym wyzwaniem DTP. Ręczna inżynieria i rygorystyczna kontrola jakości składu pozostają niezastąpione.
Niedbałe formatowanie to pierwsza rzecz, którą zauważa odbiorca. Tekst może być przetłumaczony perfekcyjnie, ale przesunięte tabele, nakładające się ramki tekstowe i zaburzona hierarchia czcionek sprawią, że dokument stanie się bezużyteczny. Oszczędzanie na DTP nieuchronnie obniża wartość całego projektu lokalizacyjnego.